Od terminali tekstowych do pierwszych kontrolerów grafiki
Era terminali tekstowych i znaków półgraficznych
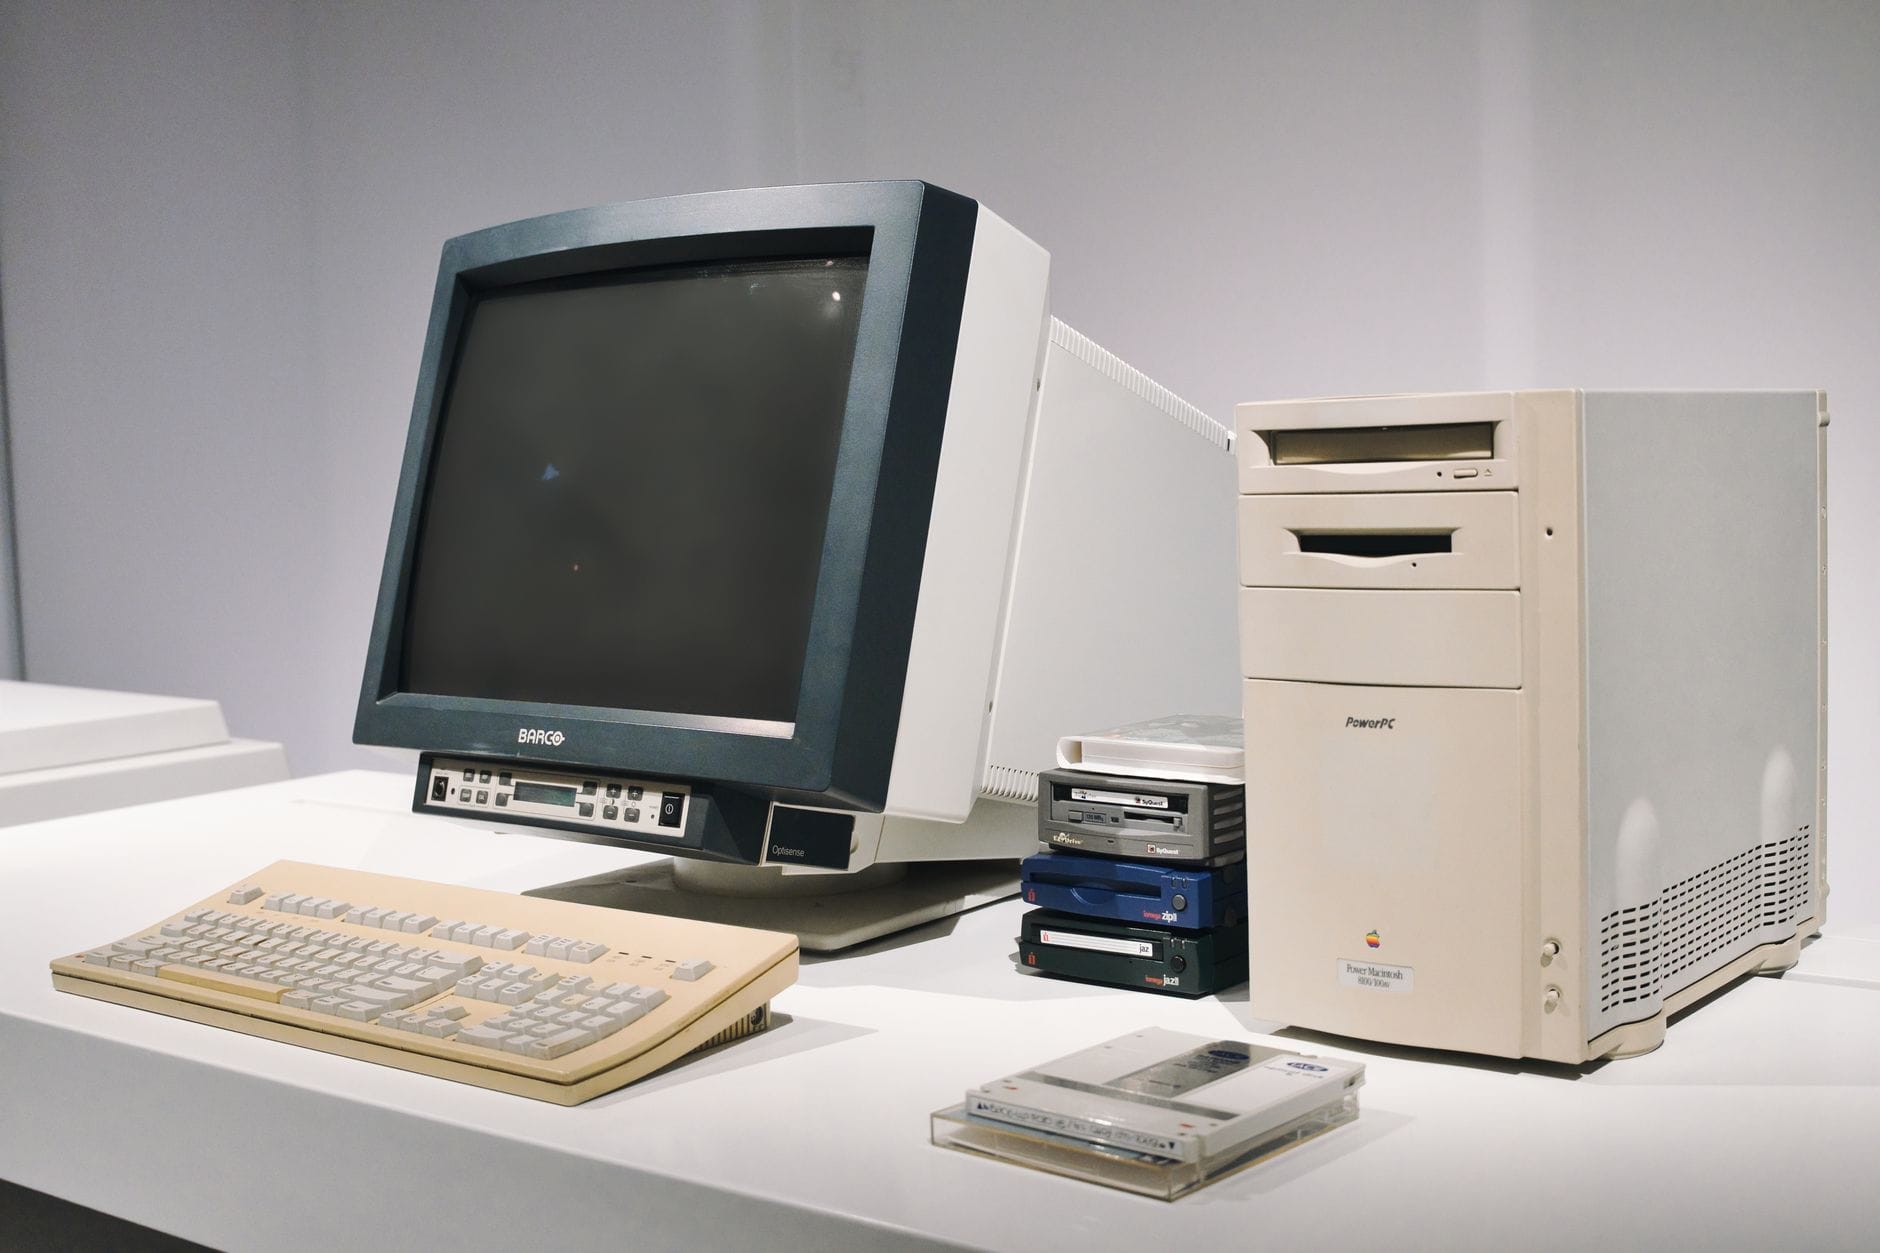
Historia kart graficznych nie zaczyna się od kolorowych pulpitów Windows ani nawet od VGA. Pierwszy etap to światy, w których „grafika” oznaczała wyłącznie tekst. Komputery pracowały z terminalami tekstowymi: monitor wyświetlał znaki z ustalonej tablicy (fontu sprzętowego), a procesor jedynie wpisywał kody znaków do pamięci ekranu. Żadnych pikseli, żadnych bitmap – tylko siatka kolumn i wierszy, np. 80×25 znaków.
Aby jakoś obejść ograniczenia, używano tzw. znaków półgraficznych: bloków, linii poziomych i pionowych, rogów ramek. Dzięki nim dało się „narysować” pseudo-okna, wykresy, proste interfejsy, ale nadal były to znaki z ustalonego zestawu. System operacyjny lub aplikacja operowały na poziomie znaków, a nie pojedynczych pikseli.
W tym modelu procesor główny (CPU) odpowiadał za całą logikę, a „karta graficzna” była w praktyce prostym kontrolerem wyświetlacza. Nie było pojęcia akceleracji, bo nie było prawdziwych operacji graficznych. CPU kopiował liczby do pamięci ekranu, a układ wideo tylko odświeżał sygnał na monitorze.
Pierwsze kontrolery wideo: CGA, Hercules, EGA
Na komputerach zgodnych z IBM PC pojawiły się pierwsze karty wideo, które znamy z nazw: CGA, Hercules, EGA. Z dzisiejszej perspektywy to prymitywne układy, ale wprowadziły kluczowe pojęcia: tryby graficzne, rozdzielczość, paletę kolorów.
CGA (Color Graphics Adapter) zapewniała zarówno tryb tekstowy, jak i graficzny. W trybie graficznym obsługiwała 320×200 pikseli w 4 kolorach z ustalonej palety lub 640×200 w dwóch kolorach. Jakość była niska, kolory wyblakłe, a artefakty na monitorach kompozytowych tworzą dziś mityczną „estetykę CGA”.
Hercules Graphics Card (HGC) poszła w inną stronę: wysoka rozdzielczość monochromatyczna 720×348 pikseli. Dla zastosowań biurowych, CAD czy edycji tekstu szczegółowość była ważniejsza niż kolor. W praktyce wiele osób z tamtych czasów pozytywnie wspomina ostrość obrazu Herculesa, mimo braku barw.
EGA (Enhanced Graphics Adapter) próbowała połączyć światy CGA i Herculesa. Oferowała do 16 kolorów z szerszej palety przy wyższej rozdzielczości, co było krokiem w stronę tego, co kojarzymy z „prawdziwą grafiką”, ale nadal było dalekie od współczesnych standardów.
Framebuffer, rozdzielczość i paleta barw w realiach lat 80.
Kluczowe pojęcie, które przewija się przez całą historię kart graficznych, to framebuffer – obszar pamięci, gdzie zapisany jest obraz do wyświetlenia. W prostym ujęciu: każdy piksel to informacje o kolorze, które muszą być przechowywane w pamięci i cyklicznie odczytywane do generowania sygnału wideo.
Nawet przy rozdzielczości rzędu 640×480 i 16 kolorach ilość potrzebnej pamięci była znacząca jak na ówczesne czasy. Typowe komputery miały po kilkadziesiąt – kilkaset kilobajtów RAM, a pamięć wideo konkurowała z pamięcią systemową o koszt i przepustowość. Dlatego stosowano tryby z małą liczbą kolorów i rozdzielczościami, które dziś wyglądają archaicznie.
Paleta barw była ograniczona przez sposób kodowania koloru. CGA pozwalała na 4 kolory z zaledwie kilkunastu możliwych kombinacji. Dopiero później pojawiły się palety 256 kolorów wybieranych z przestrzeni 262 144 barw (tzw. 18-bitowy DAC), a jeszcze później – prawdziwy kolor 16,7 mln barw (24 bity na piksel). Dla programistów oznaczało to ciągłą konieczność oszczędzania: mniejsze sprite’y, prostsze tła, palety dobierane jak najrozsądniej.
Ograniczenia: przepustowość, brak akceleracji, wszystko na barkach CPU
Wczesne kontrolery wideo nie przyspieszały obliczeń. Procesor musiał samodzielnie liczyć każdy piksel, każdą linię, każdą literę. Karta tylko tę pamięć odczytywała i zamieniała na sygnał dla monitora. To podejście miało dwa poważne ograniczenia:
Przepustowość magistrali – CPU mógł zapisywać do pamięci wideo tylko z określoną prędkością. Przy wyższych rozdzielczościach i większej liczbie klatek na sekundę trzeba było kopiować ogromne ilości danych, co szybko blokowało system.
Zużycie czasu CPU – każda operacja graficzna (rysowanie linii, wypełnienie prostokąta) wymagała pętli w kodzie CPU. Im bardziej wyrafinowany interfejs, tym więcej czasu procesora poświęconego na grafikę, kosztem logiki aplikacji.
Stąd dylematy z końca lat 80. i początku 90.: czy lepiej mieć rozbudowany, graficzny interfejs, czy jednak pozostać przy tekstowym, ale szybkim systemie. Dopiero pojawienie się akceleratorów 2D zaczęło zmieniać reguły gry.
Mit idealizowanej „grafiki retro”
W opisach historycznych łatwo trafić na idealizowanie obrazu na Amidze, Atari ST czy pierwszych kartach VGA. Faktycznie, na tle terminali tekstowych przeskok był ogromny: kolorowe gry, animacje, interfejsy okienkowe. Jednak trzeba oddzielić nostalgię od realnych parametrów.
Wiele „pięknych” gier z tamtego okresu działało w bardzo niskich rozdzielczościach, często z prostą animacją i mocną kompresją grafiki. Monitory CRT maskowały piksele i rozmywały obraz, co pomagało w odbiorze. Z dzisiejszego punktu widzenia jakość obrazu była słaba, a możliwości kart graficznych – dramatycznie ograniczone w porównaniu z współczesnymi nawet zintegrowanymi układami.
Źródło: Pexels | Autor: Nicolas Foster
Narodziny akceleratorów 2D i ery VGA
Przejście od „wyświetlaczy” do akceleratorów grafiki 2D
Kolejny krok w historii kart graficznych to transformacja z biernego urządzenia wyświetlającego obraz w aktywny akcelerator 2D. Wraz z popularyzacją systemów okienkowych (Windows, OS/2, X11) pojawiła się potrzeba szybkiego rysowania prostokątów, ikon, czcionek i przewijania okien. CPU nie nadążało przy rosnących rozdzielczościach i coraz bogatszych interfejsach.
Rozwiązaniem było przeniesienie części zadań na kartę graficzną. Pojawiły się układy z wbudowanym blitterem (Block Image Transfer) i logiką do wykonywania operacji graficznych bezpośrednio w pamięci wideo. Zamiast kopiować miliony bajtów, CPU wysyłał do karty krótkie komendy: „skopiuj ten prostokąt tu”, „wypełnij to tło”, „narysuj linię”.
To podejście nie tylko przyspieszało operacje, ale też odciążało magistralę systemową. Mniej danych musiało przepływać między pamięcią główną a pamięcią wideo, bo wiele operacji działo się lokalnie na karcie. Był to pierwszy krok w stronę myślenia o karcie graficznej jako o współprocesorze.
VGA i SVGA: standaryzacja rozdzielczości i kolorów
VGA (Video Graphics Array) wprowadziła standard, który na długie lata ustawił minimalne oczekiwania co do grafiki na PC. Tryb 640×480 w 16 kolorach dla zastosowań biurowych i 320×200 w 256 kolorach dla gier stał się de facto normą. To właśnie „256 kolorów” pozwoliło na zupełnie inną estetykę gier: płynne gradienty, bogate tła, szczegółowe sprite’y.
Wkrótce potem przyszły rozszerzenia określane ogólnie jako SVGA (Super VGA). Różni producenci dodawali własne tryby graficzne: 800×600, 1024×768 i wyższe, często wciąż z ograniczeniem do 256 kolorów. Aby skorzystać z nich w DOS, gry ładowały specjalne sterowniki lub korzystały ze standardu VESA BIOS Extensions (VBE).
W praktyce użytkownik rzadko miał pełny komfort. To, co było „standardem” na papierze, często różniło się w detalach implementacyjnych między producentami, wymagało specyficznych sterowników, a wydajność bywała nierówna. Marketing obiecywał „wysoką rozdzielczość SVGA”, a rzeczywistość potrafiła sprowadzić wszystko do kompromisów.
W epoce akceleratorów 2D rynek kart graficznych był znacznie bardziej zróżnicowany niż dzisiaj. Kilku producentów zyskało rozpoznawalność dzięki różnym priorytetom projektowym:
S3 – bardzo popularne układy, często wybierane przez producentów komputerów OEM. Słynne serie Trio i Virge (początkowo 2D) oferowały dobrą kompatybilność i przyzwoitą wydajność 2D przy umiarkowanym koszcie.
Cirrus Logic – układy znane z tanich, poprawnych kart 2D, często spotykane w laptopach i tanich komputerach biurowych. Mocno wykorzystywane w środowiskach DOS i Windows 3.x.
Tseng Labs – cenione za wysoką wydajność w DOS, szczególnie w grach i aplikacjach tekstowych. Użytkownicy zwracali uwagę na szybkość przewijania i ogólną responsywność.
ATI – początkowo również producent układów 2D, budował markę na dobrej jakości obrazu i sukcesywnie rozwijał funkcje multimedialne (akceleracja MPEG, wyjścia TV).
Matrox – słynął z wyśmienitej jakości obrazu 2D, szczególnie w wysokich rozdzielczościach i na monitorach CRT. Dla grafików DTP Matrox był często pierwszym wyborem.
Te różnice widać do dziś w opiniach „starej gwardii”: jedni chwalą szybkość Tseng Labs, inni jakość obrazu Matroxa, jeszcze inni wspominają S3 jako „złoty środek”. W praktyce były to nyuanse, ale pokazują, że już w epoce 2D istniały odmienne filozofie projektowania kart graficznych.
Typowe zadania akceleratorów 2D
Akceleratory 2D koncentrowały się na kilku powtarzalnych operacjach, które dominowały w systemach okienkowych i graficznych interfejsach użytkownika. Najważniejsze z nich to:
BitBLT (Bit Block Transfer) – szybkie kopiowanie bloków pamięci (prostokątów pikseli) w obrębie VRAM, np. podczas przewijania okna lub przesuwania widgetu.
Rysowanie linii i kształtów – sprzętowe wsparcie dla kresek, prostokątów, czasem z wypełnieniem, co przyspieszało rysowanie ramek, menu, przycisków.
Operacje na czcionkach – przyspieszanie rysowania tekstu przez kopiowanie gotowych bitmap znaków bezpośrednio do bufora ekranu.
Operacje logiczne na pikselach – proste funkcje (AND, OR, XOR) przy kopiowaniu, umożliwiające np. implementację kursora myszy bez nadpisywania tła.
Dla użytkownika końcowego objawiało się to płynniejszym przewijaniem dokumentów, szybciej reagującymi oknami i mniejszą ilością „migotania” interfejsu. Przy pracy biurowej różnice były wyraźnie odczuwalne, choć mało kto rozumiał, że stoi za tym akceleracja 2D.
Dlaczego akceleracja 2D okazała się ślepą uliczką
W połowie lat 90. akceleracja 2D wydawała się naturalnym kierunkiem rozwoju. Jednak wiele z tych wyspecjalizowanych funkcji okazało się trudnych do dalszej rozbudowy, gdy na scenę zaczęła wchodzić grafika 3D. Twardo zakodowane jednostki do rysowania linii i prostokątów nie nadawały się do nowych zadań, takich jak rasteryzacja trójkątów czy zaawansowane teksturowanie.
Przy przejściu do środowiska Windows i API graficznego GDI wiele operacji mogło pozostać „po stronie CPU”, korzystając z coraz szybszych procesorów. Wraz z nadejściem sprzętowo akcelerowanej grafiki 3D i odciążeniem CPU w tym obszarze zapotrzebowanie na ekstremalnie wydajne 2D stopniowo malało.
W efekcie wiele specjalistycznych funkcji 2D albo zostało uproszczonych, albo w nowszych kartach po prostu zanikało. Jednocześnie jednak doświadczenia z akceleracją 2D – zarządzanie pamięcią, komendy wysokiego poziomu, integracja ze sterownikami systemu – przygotowały grunt pod znacznie bardziej złożone akceleratory 3D.
Pierwsze podejścia do grafiki 3D na PC
Grafika 3D realizowana programowo: Doom, Quake i spółka
Zanim na rynek trafiły karty pokroju 3Dfx Voodoo, grafika 3D na PC była realizowana niemal wyłącznie programowo, czyli przez CPU. Gry takie jak Wolfenstein 3D i Doom stosowały sprytne sztuczki (tzw. „silnik pseudo-3D”), aby budować wrażenie trójwymiaru przy relatywnie niewielkim koszcie obliczeniowym. Prawdziwe 3D z pełną swobodą kamery zaczęło się rozpowszechniać dopiero z Quake i kolejnymi tytułami.
Ograniczenia renderowania programowego
Renderowanie 3D wyłącznie na CPU szybko natrafiło na twarde limity. Nawet bardzo sprytne silniki, takie jak ten użyty w Doomie, opierały się na szeregu założeń upraszczających scenę: brak pełnej swobody patrzenia w górę i dół, ograniczenia w geometrii (brak „pokoju nad pokojem”), ruchome obiekty traktowane często jak billboardy 2D. Dzięki temu liczba operacji na klatkę pozostawała względnie przewidywalna.
Gdy twórcy gier zaczęli iść w stronę prawdziwego 3D, pojawiły się kosztowne etapy: transformacja współrzędnych wierzchołków, obliczanie oświetlenia, cieniowanie pikseli, teksturowanie, a do tego zarządzanie złożonymi scenami. CPU musiało dzielić te zadania z logiką gry, fizyką, AI, dźwiękiem. Efekt był prosty: aby zachować płynność, trzeba było ciąć jakość grafiki lub komplikację świata.
W tym czasie powstawały też wyspecjalizowane biblioteki programowe, jak 3D-API od Rendition czy software’owe renderery wielu studiów. Pozwalały osiągać niezłe efekty na ówczesnym sprzęcie, ale każde dodatkowe źródło światła, większa tekstura czy wyższa rozdzielczość drastycznie obciążały CPU. Doszło do momentu, gdy kolejne generacje procesorów poprawiały sytuację tylko częściowo, a oczekiwania graczy rosły szybciej niż moc pojedynczego rdzenia.
DOS, sterowniki i chaos wczesnych API 3D
Początek akceleracji 3D na PC to okres sporego zamieszania. Nie istniał jednolity standard, a producenci kart próbowali forsować własne rozwiązania. Gry pod DOS często komunikowały się z kartą bezpośrednio, obchodząc system operacyjny i sterowniki systemowe. Każda karta mogła wymagać osobnego pliku .DLL lub zestawu bibliotek dostarczonych na dyskietce czy płycie CD.
Pierwsze próby unifikacji przyniosły interfejsy takie jak 3Dfx Glide, wczesne wersje Direct3D, różne dialekty OpenGL oraz firmowe API mniej znanych producentów. Efekt dla użytkownika bywał kuriozalny: jedna gra działała świetnie na Voodoo, ale kiepsko na Riva 128, inna wymagała osobnego „patcha OpenGL” od producenta karty, jeszcze inna miała własny, wbudowany renderer dla kilku wybranych układów.
Rynek w naturalny sposób dążył do standaryzacji. Deweloperzy nie chcieli utrzymywać kilku równoległych ścieżek kodu. Gracze też szybko tracili cierpliwość do ręcznego wybierania sterowników i patchy. W dłuższej perspektywie przetrwały tylko te API, które zapewniały względnie stabilny, wspólny mianownik: hardware’owe OpenGL w zastosowaniach profesjonalnych i Direct3D w grach na Windows.
Narodzinom akceleratorów 3D towarzyszyły liczne „półśrodki”
W przejściowym okresie pojawiały się układy nazywane marketingowo „3D”, które w praktyce niewiele miały wspólnego z pełnowymiarową kartą 3D. Część z nich przyspieszała tylko wybrane etapy renderingu: mapowanie tekstur, zeta-bufor, filtrowanie. Inne oferowały „tryby 3D”, ale działały wyłącznie w kilku konkretnych rozdzielczościach, bez pełnego wsparcia dla wszystkich efektów stosowanych przez deweloperów gier.
Niektóre konstrukcje potrafiły przyspieszyć starsze tytuły lub dema technologiczne, ale w zderzeniu z następną falą gier traciły sens. Częścią problemu było też to, że twórcy gier musieli programować „pod konkretny chip”, zamiast pod abstrakcyjną warstwę API. Jeśli układ implementował pewne funkcje sprzętowo, ale API nie miało ich standardowego odpowiednika, pełnia możliwości pozostawała niewykorzystana.
Źródło: Pexels | Autor: Ruben Boekeloo
Era „wojen GPU”: 3Dfx, Nvidia, ATI/AMD i reszta
3Dfx Voodoo: pierwszy „kultowy” akcelerator 3D
Za symboliczny początek ery masowego 3D na PC często uznaje się 3Dfx Voodoo. Nie był to pierwszy układ 3D w ogóle, ale trafił w rzadkie połączenie: sensowna moc obliczeniowa, dobrze zaprojektowane API Glide, rozsądny model sterowników i ścisła współpraca z twórcami gier. Co ważne, Voodoo był z reguły dodatkową kartą, pracującą obok istniejącego akceleratora 2D i łączoną z nim specjalnym kabelkiem pass-through.
Ograniczenie do określonych rozdzielczości (najczęściej 640×480) i brak obsługi 2D upraszczały projekt układu. Cała krzemowa powierzchnia mogła zostać poświęcona na funkcje istotne z punktu widzenia gier: rasteryzację trójkątów, filtrowanie tekstur, z-bufor, proste efekty przezroczystości. W praktyce różnica między wersją gry z obsługą Voodoo a czysto programową bywała tak duża, że gracze traktowali brak akceleratora jako poważną przeszkodę.
Wejście Nvidii i upadek 3Dfx
Nvidia w pierwszych latach nie była oczywistym liderem. Wczesne układy, jak NV1, eksperymentowały choćby z geometrią kwadratową zamiast trójkątów, co utrudniało adaptację. Przełom nastąpił z rodziną RIVA (128, TNT, TNT2), gdy firma postawiła na standardowe API (Direct3D, OpenGL) i pełną kartę 2D/3D w jednym. Z punktu widzenia użytkownika oznaczało to koniec kabli przełączających między osobnymi kartami i prostszy model sterowników.
3Dfx z kolei próbowało utrzymać przewagę wydajności, rozwijając kolejne generacje Voodoo i forsując Glide. Przez pewien czas przewaga jakości obrazu i płynności była realna, ale rynek coraz mocniej przesuwał się w stronę otwartych API. Ostatecznie 3Dfx przegrało z kombinacją agresywnej strategii produktowej Nvidii, rosnącej konkurencji cenowej i własnych błędów biznesowych. Finałem było wykupienie części aktywów 3Dfx przez Nvidię.
ATI/AMD: od „goniącego peletonu” do równorzędnego konkurenta
ATI początkowo kojarzono bardziej z solidnym 2D i funkcjami multimedialnymi niż z „twardym” 3D. Seria Rage oferowała akcelerację 3D, ale często z kompromisami: brak pełnego wsparcia dla wszystkich trybów teksturowania, problemy sterowników, nie zawsze idealna zgodność z rosnącą bazą gier Direct3D.
Zmiana nastąpiła z debiutem serii Radeon. Architektura nastawiona na szeroką przepustowość, rozbudowane jednostki shaderów (jak na ówczesne standardy) i agresywna walka cenowa postawiły ATI w roli realnego rywala Nvidii. Przez kolejne lata rynkowy obraz często wyglądał tak: Nvidia dominowała w absolutnej wydajności topowych modeli, natomiast ATI (a później AMD po przejęciu) oferowało atrakcyjny stosunek cena/wydajność w średnim segmencie.
Inni uczestnicy wyścigu: Matrox, S3, PowerVR
W „złotych latach” wojen GPU poza wielką trójką pojawiało się wielu graczy, którzy próbowali swoich sił w 3D. Część z nich znikała po jednej czy dwóch generacjach, innym udało się znaleźć wąskie nisze.
Matrox – słynął z jakości obrazu i bardzo dobrego 2D, ale w 3D zwykle zostawał krok z tyłu za Nvidią i ATI. Karty takie jak G400 miały grupę oddanych fanów, ale brak agresywnego rozwoju 3D i ostrożna polityka produktowa sprawiły, że firma stopniowo wycofała się z rynku masowego.
S3 – po sukcesach w 2D próbowało sił z rodziną Virge i kolejnymi układami 3D, lecz rynek szybko ocenił je jako „3D-decelerators” z powodu ograniczonej wydajności. W późniejszym okresie technologia S3 trafiła raczej do zintegrowanych układów niż do topowych kart.
PowerVR – eksperymentował z tzw. renderowaniem kafelkowym (tile-based deferred rendering). Na desktopie rozwiązania te nie zdobyły masowej popularności, ale ta filozofia architektury powróciła z sukcesem w urządzeniach mobilnych, gdzie oszczędność energii stała się kluczowa.
W efekcie długofalowo utrzymał się model duopolu Nvidia–ATI/AMD w kartach konsumenckich, podczas gdy inni gracze znaleźli miejsce w GPU zintegrowanych, kartach profesjonalnych lub systemach wbudowanych.
Rośnie znaczenie sterowników i ekosystemu
Same parametry sprzętu coraz rzadziej wystarczały do oceny karty. Coraz większą rolę odgrywały sterowniki: ich stabilność, wydajność w konkretnych grach, tempo wydawania aktualizacji pod nowe tytuły. Zdarzały się przypadki, gdy teoretycznie słabszy układ z dopracowanymi sterownikami radził sobie lepiej niż konkurent z mocniejszymi parametrami „na papierze”.
Równolegle rosło znaczenie narzędzi deweloperskich: profilerów GPU, bibliotek do zarządzania efektami (np. pakiety typu „GameWorks”), dokumentacji i wsparcia technicznego. Producenci GPU zaczęli inwestować w relacje ze studiami, współtworząc dema technologiczne, pomagając optymalizować silniki i wprowadzając rozwiązania „pod konkretną architekturę”. W dłuższym okresie to właśnie ekosystem – a nie pojedyncze cechy krzemu – coraz mocniej różnicował oferty.
Źródło: Pexels | Autor: Derek Xing
Architektura GPU – inne spojrzenie na obliczenia
Dlaczego GPU nie jest po prostu „szybszym CPU”
Na poziomie marketingu często pojawia się porównanie: „karta ma kilka tysięcy rdzeni, CPU ma tylko kilka”. Tego typu zestawienia są mylące, bo rdzeń CPU i „rdzeń” GPU to zupełnie inne jednostki. CPU jest projektowane jako uniwersalny procesor ogólnego przeznaczenia: rozbudowana logika sterująca, głęboka hierarchia cache’y, silne jednostki do pojedynczych wątków, skomplikowane mechanizmy przewidywania skoków i spekulacji.
GPU idzie w przeciwnym kierunku. Większość tranzystorów rezerwuje na proste, powielone wiele razy jednostki arytmetyczne, zdolne wykonywać te same operacje na dużych porcjach danych. Logika sterująca jest możliwie uproszczona, a zakłada się, że kod będzie mocno zrównoleglony i relatywnie jednolity (te same instrukcje na wielu elementach danych). Dlatego GPU świetnie radzi sobie z zadaniami typu „oblicz to samo dla milionów pikseli czy wierzchołków”, a gorzej w scenariuszach silnie rozgałęzionych z nieprzewidywalnym przepływem sterowania.
Model SIMD/SIMT i bloki wątków
Większość współczesnych GPU stosuje wariant modelu SIMD (Single Instruction, Multiple Data) albo SIMT (Single Instruction, Multiple Threads). W uproszczeniu grupa wątków – np. 32 lub 64 – wykonywana jest w „lock-stepie”: w danym cyklu wszystkie wykonują tę samą instrukcję, choć na różnych danych. Gdy część wątków w grupie wejdzie w inny warunek (if), pozostałe muszą czekać lub wykonywać „puste” operacje, co powoduje zjawisko określane jako divergency.
Ten model jest znakomity dla zadań takich jak rasteryzacja trójkątów, cieniowanie pikseli, filtrowanie tekstur – tam każdy fragment obrazu wymaga podobnego ciągu obliczeń. Natomiast algorytmy z dużą liczbą rozgałęzień, nieregularnym dostępem do pamięci czy zależnościami między krokami trudniej dopasować do architektury GPU, co często prowadzi do rozczarowujących wyników mimo „tysięcy rdzeni na karcie”.
Hierarchia pamięci: przepustowość zamiast niskich opóźnień
CPU jest projektowane tak, by skrócić opóźnienie dostępu do danych: wielopoziomowe cache’e, zaawansowane mechanizmy prefetchingu, spekulacja. GPU stawia przede wszystkim na przepustowość: szeroka magistrala do pamięci VRAM, często pamięci typu GDDR lub HBM o bardzo wysokiej szybkości transferu, ale wyższych opóźnieniach niż typowy DRAM w systemie.
Aby efektywnie wykorzystać tę przepustowość, GPU potrzebuje tysięcy aktywnych wątków, które mogą być przełączane sprzętowo, gdy jedne czekają na dane, inne wykonują obliczenia. Jeśli algorytm nie jest w stanie wystarczająco „napełnić” procesora pracą (zbyt mało równoległości, za dużo synchronizacji), duża część teoretycznej mocy pozostaje niewykorzystana. To jedna z głównych pułapek przy przenoszeniu kodu z CPU na GPU.
Stałofunkcyjne bloki GPU
Wbrew popularnemu uproszczeniu, GPU nie składa się wyłącznie z „programowalnych shaderów”. Istotną część układu wciąż stanowią stałofunkcyjne bloki, wykonujące wybrane zadania znacznie efektywniej energetycznie niż ogólne jednostki arytmetyczne. Przykłady to:
jednostki rasteryzacji trójkątów i generowania pikseli (ROP-y),
specjalizowane jednostki filtrowania tekstur,
układy kodowania/dekodowania wideo (NVENC, VCE, UVD itd.),
akceleratory ray tracingu (RT cores, Ray Accelerators).
To one zapewniają wysoką wydajność w typowych scenariuszach graficznych oraz multimedialnych, ale równocześnie ograniczają elastyczność: jeśli zadanie wykracza poza przewidziane przez projektantów ścieżki, musi wrócić do jednostek programowalnych, co bywa kosztowne.
Elastyczność programowalna kontra złożoność sterowania
Od czasów pierwszych shaderów programowalnych GPU przesunęły się od ściśle zdefiniowanego potoku grafiki 3D do coraz szerszego modelu programowalnego. Możliwość pisania własnych shaderów w HLSL/GLSL, a później CUDA, OpenCL czy Metal, otworzyła drogę nie tylko do nowych efektów graficznych, ale też do zupełnie innych klas zadań. Ten zysk elastyczności nie jest jednak „darmowy”.
Każdy dodatkowy stopień swobody wymaga bardziej złożonej logiki sterującej, większych rejestrów, bardziej skomplikowanego harmonogramowania wątków. Z jednej strony rośnie liczba możliwych zastosowań, z drugiej – łatwiej o sytuacje, w których programista przypadkiem ustawia GPU w niekorzystnej konfiguracji (np. zbyt małe grupy wątków, źle dopasowane wzorce dostępu do pamięci). To dlatego dwie aplikacje korzystające z tej samej karty potrafią różnić się wydajnością o rząd wielkości – nie przez „magiczne sterowniki”, lecz przez jakość dopasowania kodu do faktycznej architektury.
W praktyce prowadzi to do ciekawego paradoksu: nowoczesne GPU są bardzo ogólne w teorii, ale w codziennej pracy są najbardziej efektywne wtedy, gdy trzymamy się kilku dobrze znanych, „ulubionych” przez architekturę wzorców obliczeń. Wyjście poza nie jest możliwe, lecz pociąga za sobą koszt, który nie zawsze widać w marketingowych slajdach.
Znaczenie przepływu danych w projektowaniu algorytmów GPU
W klasycznych opisach wydajności często eksponuje się liczbę operacji zmiennoprzecinkowych na sekundę (FLOPS). Dla GPU ten parametr szybko okazuje się wtórny względem organizacji przepływu danych. Samo przeniesienie algorytmu z CPU „jeden do jednego” rzadko ma sens – zwykle trzeba go rozłożyć i ułożyć od nowa pod kątem:
koaleskowanego dostępu do pamięci globalnej,
maksymalnego ponownego wykorzystania danych w pamięci współdzielonej,
minimalizacji synchronizacji między blokami wątków.
Typowy błąd wygląda tak: zespół przepisuje kod pętli z CPU do kernela GPU, licząc na „100× szybciej”, a otrzymuje przyspieszenie symboliczne lub wręcz spowolnienie. Powód: każda iteracja pętli powoduje nieregularne skoki po pamięci, a wątków jest za mało, by ukryć opóźnienia. Dopiero przeprojektowanie struktury danych – np. przejście z „tablicy struktur” (AoS) na „strukturę tablic” (SoA) – pozwala GPU rozwinąć skrzydła.
Nie jest to drobiazg implementacyjny, lecz konsekwencja samego fundamentu architektonicznego. GPU zakłada, że dane przychodzą dużymi, niemal strumieniowymi porcjami. Jeśli aplikacja wciąż myśli kategoriami „losowych, małych odczytów”, korzysta z GPU tylko powierzchownie.
Od grafiki do obliczeń ogólnego przeznaczenia: narodziny GPGPU
Pierwsze „hacki” na shaderach
Zanim pojawiły się oficjalne frameworki typu CUDA czy OpenCL, badacze i inżynierowie zaczęli wykorzystywać programowalne shadery do obliczeń, które z grafiką miały wspólny tylko formalny model danych. Dane numeryczne pakowano do tekstur, obliczenia implementowano jako programy cieniujące, a wynik odczytywano z bufora ramki lub tekstur zwrotnych.
Takie podejście miało szereg ograniczeń: ograniczoną precyzję, brak wygodnego wsparcia dla warunków i pętli, konieczność „udawania” operacji ogólnego przeznaczenia za pomocą prymitywów graficznych. Mimo to już wtedy pojawiły się publikacje pokazujące przyspieszenia w renderingu globalnego oświetlenia, symulacjach płynów czy przetwarzaniu obrazu. To był pierwszy dowód, że GPU można traktować jako akcelerator macierzy i tensorów, a nie tylko trójkątów i pikseli.
Nvidia CUDA: zamiana tricków w oficjalny model programowania
Przełom nastąpił, gdy Nvidia wprowadziła architekturę Tesla i środowisko CUDA. Z punktu widzenia programisty zmieniono układ sił: zamiast traktować GPU jako „czarną skrzynkę” z shaderami, można było pisać funkcje w stylu C, uruchamiane równolegle na setkach lub tysiącach wątków. Kluczowe elementy tego modelu to:
hierarchiczna organizacja wątków (grid, bloki, wątki w bloku),
jawna kontrola nad pamięcią współdzieloną,
możliwość asynchronicznych transferów danych między CPU a GPU.
Paradoksalnie, CUDA nie uczyniła GPU „łatwym” narzędziem programistycznym – ujawniła za to wprost wszystkie zależności wydajnościowe, które wcześniej maskowały sterowniki graficzne. Dla doświadczonych inżynierów HPC był to atut: można było świadomie zarządzać lokalnością danych, dopasowywać rozmiary bloków do struktury multiprocesorów, unikać divergency.
Otworzyło to drogę do portowania na GPU całych klas zadań: symulacji fizycznych, metod Monte Carlo, obliczeń numerycznych w inżynierii czy przetwarzania sygnałów. Nie zawsze dawało to spektakularne przyspieszenia – sporo algorytmów pozostaje trudnych dla architektury GPU – ale tam, gdzie występowała naturalna, masowa równoległość, wyniki były trudne do zignorowania.
OpenCL i próby unifikacji ekosystemu
W odpowiedzi na dominację CUDA konsorcjum Khronos zaproponowało OpenCL – otwarty standard mający objąć różne typy akceleratorów: GPU, CPU, DSP, FPGA. Teoretycznie rozwiązanie idealne: jeden model programowania, wiele możliwych implementacji. Praktyka okazała się mniej różowa.
Główne problemy były dwa. Po pierwsze, sam język i API były skomplikowane w użyciu, co zniechęcało część deweloperów. Po drugie, jakość i dojrzałość implementacji różniły się znacząco między dostawcami, więc kod „portable w teorii” często trzeba było optymalizować osobno pod każdą platformę. W rezultacie OpenCL znalazł miejsce w niszach, gdzie mobilność była absolutnym priorytetem, ale nie zdołał realnie zagrozić CUDA w świecie HPC i AI.
Mimo to sam fakt istnienia OpenCL oraz kolejnych inicjatyw (SYCL, HIP, oneAPI) pokazuje, że napięcie między wygodą jednego dominującego ekosystemu a potrzebą unikania vendor lock-in pozostaje aktualne. Z perspektywy użytkownika centrów danych wybór między „najlepszą wydajnością dziś” a „mniejszą zależnością od jednego dostawcy jutro” nie ma prostych odpowiedzi.
GPU w obliczeniach naukowych i inżynierskich
Środowiska naukowe i inżynierskie jako jedne z pierwszych adoptowały GPGPU na szeroką skalę. Klastry obliczeniowe zaczęto wyposażać w węzły z kartami Tesla i odpowiednikami od AMD, a biblioteki takie jak cuBLAS, cuFFT, MAGMA czy później cuSPARSE stały się standardem w dziedzinach wymagających algebry liniowej dużej skali.
Nie każdy problem „nadaje się na GPU”, ale wiele typowych zadań naukowych wykazuje silną strukturę macierzową lub wektorową. Przykładowo:
symulacje metodą elementów skończonych czy objętości skończonych – duże, często rzadkie macierze, powtarzalne operacje,
analiza danych w fizyce wysokich energii – miliardy zdarzeń o podobnej strukturze,
mechanika płynów – iteracyjne rozwiązywanie układów równań na regularnych siatkach.
W tych obszarach GPU nie tyle zastąpiły CPU, co przejęły rolę „silników numerycznych” dla najbardziej kosztownych fragmentów kodu. Typowy scenariusz: CPU odpowiada za logikę sterującą, organizację zadań, I/O, natomiast GPU realizują „gorące pętle”, często w formie wywołań wyspecjalizowanych bibliotek. To rozdzielenie ról później niemal bezpośrednio przeniosło się do świata uczenia maszynowego.
Od klasycznych HPC do uczenia maszynowego
Gdy pierwsze modele głębokich sieci neuronowych zaczęto trenować na GPU, architektura kart idealnie zgrała się z naturą obliczeń: masowe mnożenia macierzy i wektorów, powtarzalne operacje na dużych tensorach, prosty wzorzec przepływu danych. W tym przypadku model obliczeniowy sieci lepiej pasował do GPU niż wiele wcześniejszych zadań naukowych, które częściej zawierały nieregularne struktury (np. złożone grafy, adaptacyjne siatki).
W praktyce można mówić o „drugiej fali” GPGPU. Pierwsza – naukowo-inżynierska – koncentrowała się na portowaniu istniejących kodów. Druga – związana z AI – od razu projektowała algorytmy i biblioteki (TensorFlow, PyTorch, JAX) tak, aby domyślnym celem były GPU. W efekcie zamiast adaptować kod do GPU, zaczęto od początku budować modele i frameworki pod karty graficzne, a CPU zredukowano do roli koordynatora.
Ten odwrócony punkt widzenia tłumaczy, dlaczego GPU tak szybko stały się filarem nowoczesnych centrów danych AI. Nie chodziło tylko o „więcej FLOPS”, lecz o to, że dominujący paradygmat obliczeń został świadomie dostosowany do ich natury.
Architektury tensorowe: specjalizacja w ramach GPU
Kolejnym krokiem w stronę akceleracji AI było wprowadzenie w GPU dedykowanych jednostek tensorowych (Tensor Cores, Matrix Cores i ich odpowiedniki). Z technicznego punktu widzenia to wyspecjalizowane bloki wykonujące małe mnożenia macierzy (np. 4×4, 16×16) sprzętowo, z obsługą niższych precyzji (FP16, BF16, INT8). Dzięki temu przepustowość operacji istotnych dla sieci neuronowych rośnie wielokrotnie względem klasycznych jednostek FP32.
Nie oznacza to, że klasyczna część GPU stała się zbędna. Tensor Cores są efektywne tylko wtedy, gdy biblioteki i kompilatory potrafią rozłożyć większe operacje na odpowiednie kafelki i zadbać o logistykę danych. W praktyce znów liczy się całość stosu: od architektury sprzętu, przez sterowniki i kompilator, po biblioteki wysokiego poziomu (cuDNN, CUTLASS, biblioteki inferencyjne). Surowa obecność „tensorowych jednostek” niewiele daje, jeśli oprogramowanie nie potrafi ich nakarmić.
To prowadzi do kolejnego uproszczenia, które często pojawia się w przekazie marketingowym: porównywanie tylko teoretycznych TOPS/FLOPS w niskiej precyzji. W rzeczywistych obciążeniach AI ograniczeniem bywa nie sama liczba operacji, lecz przepustowość pamięci, efektywność planowania grafu obliczeń, a nawet narzut komunikacji między wieloma GPU w klastrze.
GPU jako element infrastruktury centrów danych
Gdy GPU zaczęły pełnić rolę głównego źródła mocy obliczeniowej w centrach danych AI, zmienił się też sposób projektowania całej infrastruktury. Pojawiły się wyspecjalizowane serwery z gęstym upakowaniem kart, wysokonapięciowe zasilanie, rozbudowane systemy chłodzenia cieczą, a także dedykowane sieci o bardzo małych opóźnieniach (InfiniBand, NVLink, NVSwitch i ich odpowiedniki).
W odróżnieniu od klasycznych klastrów CPU, gdzie skalowanie horyzontalne jest stosunkowo proste, w klastrach GPU wąskim gardłem szybko staje się komunikacja między kartami. Trening dużego modelu wymaga ciągłej wymiany gradientów i parametrów; jeśli sieć nie nadąża, drogie GPU „nudzą się” czekając na dane. To powód, dla którego producenci kart inwestują nie tylko w same chipy, ale też w rozwiązania sieciowe i oprogramowanie do skalowania rozproszonego (NCCL, Horovod, DeepSpeed, Megatron-LM i inne).
Warto też zauważyć przesunięcie akcentów w kierunku zarządzania energią. Pojedynczy serwer z kilkoma topowymi GPU potrafi pobierać kilkukrotnie więcej mocy niż klasyczny serwer CPU. Przy setkach czy tysiącach takich węzłów całkowite zużycie energii staje się jednym z głównych czynników kosztowych i projektowych. To dlatego obok „czystej wydajności” coraz częściej analizuje się relację wydajność na wat, a nie tylko „na dolar”.
Relacja GPU z innymi akceleratorami AI
Dominacja GPU w AI nie oznacza braku konkurencji. Google wprowadziło TPU, inni dostawcy pracują nad własnymi ASIC-ami i układami typu NPU. Te specjalizowane akceleratory są w stanie osiągać imponującą efektywność energetyczną w wąsko zdefiniowanych scenariuszach (np. inference w chmurze), lecz ceną jest mniejsza elastyczność i trudniejsze dostosowanie do szybko zmieniających się architektur modeli.
GPU pełnią rolę rozwiązania „ogólnego” w świecie akceleratorów AI – są mniej wyspecjalizowane niż dedykowane ASIC, ale dzięki temu lepiej radzą sobie z kolejnymi generacjami modeli, nowymi typami warstw czy hybrydami uczenia nadzorowanego, samonadzorowanego i reinforcement learningu. Do tego dochodzi efekt skali: ogromny ekosystem bibliotek, narzędzi i doświadczeń sprawia, że dla wielu organizacji wejście w świat innego typu akceleratora oznaczałoby realne koszty migracji, nawet jeśli sprzętowo oferuje on przewagę.
W praktyce coraz częściej pojawia się model „heterogenicznego” centrum danych: GPU realizują trening największych modeli i złożone zadania badawcze, podczas gdy lżejsze inferencje – zwłaszcza o przewidywalnych wzorcach – migrują na wyspecjalizowane układy, czy to w chmurze, czy w urządzeniach brzegowych. To bardziej przesunięcie akcentów niż „koniec GPU”.
GPU poza centrum danych: edge, embedded, urządzenia konsumenckie
Najczęściej zadawane pytania (FAQ)
Od czego tak naprawdę zaczyna się historia kart graficznych?
Praktyczny początek to terminale tekstowe, gdzie „grafika” była tylko układem znaków na ekranie, najczęściej w siatce 80×25. Nie było pikseli w dzisiejszym sensie, a kontroler wideo jedynie wyświetlał znaki zapisane w pamięci ekranu.
Wczesne układy wideo pełniły rolę prostych kontrolerów wyświetlacza. CPU wpisywał kody znaków lub bajty do pamięci ekranu, a układ wideo tylko odświeżał obraz. O akceleracji grafiki nie mogło być mowy, bo nie wykonywano jeszcze żadnych „operacji graficznych” na karcie.
Czym różniły się karty CGA, Hercules i EGA w komputerach PC?
CGA łączyła tryb tekstowy i graficzny, ale z bardzo skromnymi parametrami: 320×200 pikseli w 4 kolorach albo 640×200 w dwóch. Obraz był ziarnisty, a paleta kolorów mocno ograniczona, co dziś kojarzy się z charakterystyczną, „ostro” wyglądającą grafiką retro.
Hercules stawiał na wysoką, jak na swoje czasy, rozdzielczość monochromatyczną 720×348 pikseli. To było praktyczne w biurze czy w CAD, bo liczyła się ostrość tekstu i kształtów, a nie kolor. EGA próbowała połączyć oba światy: wyższą rozdzielczość i do 16 kolorów z szerszej palety, co już bardziej przypominało „prawdziwą grafikę”, choć wciąż daleko od dzisiejszych standardów.
Co to jest framebuffer i dlaczego był problemem w latach 80.?
Framebuffer to wydzielony obszar pamięci, w którym zapisany jest aktualny obraz ekranu: kolor każdego piksela lub indeks z palety. Układ wideo nie „domyśla się” niczego – po prostu cyklicznie odczytuje tę pamięć i generuje sygnał wideo.
Przy ówczesnych cenach pamięci nawet rozdzielczości typu 640×480 w 16 kolorach wymagały sporej ilości RAM jak na możliwości domowego komputera. Pamięć wideo konkurowała z pamięcią systemową o budżet kosztów i przepustowości. Dlatego producenci często ograniczali liczbę kolorów i rozdzielczość, a programiści musieli oszczędzać każdy bajt grafiki, stosując małe sprite’y i ostrożnie dobrane palety.
Dlaczego wczesne gry i interfejsy były tak wolne przy wyższych rozdzielczościach?
Wczesne karty wideo nie przyspieszały przetwarzania grafiki, tylko przechowywały obraz. Każde narysowanie linii, wypełnienie prostokąta czy przesunięcie okna wymagało pętli na CPU, która zapisywała dane piksel po pikselu do pamięci wideo. Im większa rozdzielczość i liczba klatek, tym więcej danych trzeba było przepchnąć przez magistralę.
Efekt był podwójny: z jednej strony ograniczeniem była przepustowość magistrali (nie dało się wystarczająco szybko zapisywać do VRAM), z drugiej – czas procesora poświęcony na „rysowanie” zamiast na logikę gry czy aplikacji. Stąd ówczesne dylematy: interfejs tekstowy i szybko, czy graficzny, ale z wyraźnym spadkiem wydajności.
Czym były akceleratory 2D i blitter, i co zmieniły?
Akceleratory 2D to karty graficzne, które przestały być tylko „wyświetlaczami”, a zaczęły samodzielnie wykonywać typowe operacje graficzne: kopiowanie bloków obrazu, wypełnianie obszarów, rysowanie linii i kształtów. Kluczowym elementem był tzw. blitter (Block Image Transfer), czyli układ do szybkiego przenoszenia bloków danych w pamięci wideo.
CPU zamiast w kółko kopiować piksele, wysyłał do karty krótką komendę: co, skąd i dokąd trzeba przenieść lub narysować. Operacja działała lokalnie w VRAM, więc mniej danych krążyło po magistrali, a procesor był odciążony. Dla systemów okienkowych (Windows, X11) oznaczało to wyraźny skok płynności przy przewijaniu, przesuwaniu okien i renderowaniu interfejsu.
Dlaczego VGA i SVGA uznaje się za przełom w historii grafiki na PC?
VGA ustaliła wspólny „punkt odniesienia”: tryb 640×480 w 16 kolorach dla pracy biurowej i 320×200 w 256 kolorach dla gier. Ten ostatni tryb pozwolił na znacznie bogatszą grafikę – łagodniejsze przejścia kolorów, szczegółowe tła, bardziej złożone sprite’y. Programista mógł wreszcie zakładać, że użytkownik zobaczy coś więcej niż kilka podstawowych barw.
SVGA (Super VGA) to zbiorcza nazwa dla rozszerzeń ponad VGA, oferujących wyższe rozdzielczości (800×600, 1024×768 i dalej), zwykle jeszcze z ograniczeniem do 256 kolorów. Problem w tym, że implementacje różnych producentów różniły się detalami, więc gry i programy musiały korzystać z dodatkowych sterowników lub standardu VESA VBE. Na pudełku widniało „SVGA”, ale realna kompatybilność i wydajność bywała bardzo różna.
Czy „grafika retro” naprawdę była tak dobra, jak się dziś wspomina?
Wspomnienia są zwykle dużo łagodniejsze niż statyczny zrzut ekranu na współczesnym monitorze LCD. Wiele kultowych gier działało w bardzo niskich rozdzielczościach, z prostą animacją i intensywną kompresją grafiki, bo tak dyktowały ograniczenia pamięci i przepustowości.
Monitory CRT rozmywały obraz i maskowały pojedyncze piksele, co w praktyce wygładzało krawędzie i poprawiało odbiór. Stąd częste zaskoczenie, gdy ktoś uruchamia starą grę w natywnej rozdzielczości na nowym monitorze: nostalgia mówi jedno, surowe parametry sprzętu – coś zupełnie innego.
Co warto zapamiętać
Początkowe „karty graficzne” były w praktyce kontrolerami tekstu: operowały na siatce znaków (np. 80×25), bez pikseli i bitmap, a cała logika i „grafika” leżała na barkach CPU.
Układy CGA, Hercules i EGA wprowadziły fundamenty współczesnego myślenia o obrazie – tryby graficzne, rozdzielczość, paletę barw – choć z dzisiejszej perspektywy oferowały bardzo skromną jakość i funkcjonalność.
Framebuffer od początku stanowił kluczowe, ale kosztowne zasobożerne miejsce: nawet niskie dzisiejszymi oczami rozdzielczości wymagały odczuwalnej ilości pamięci i przepustowości, co ograniczało liczbę kolorów i szczegółowość scen.
Wczesne systemy graficzne były całkowicie nieakcelerowane: każda linia, prostokąt czy znak były liczone pętlą w CPU, co szybko zjadało czas procesora i przepustowość magistrali, szczególnie przy wyższych rozdzielczościach.
Dylemat z końca lat 80. i początku 90. był realny: bogatszy graficznie interfejs oznaczał wyraźne spowolnienie pracy systemu, dlatego część użytkowników pozostawała przy szybkim, ale „brzydszym” trybie tekstowym.
Nostalgiczna wizja „pięknej grafiki retro” jest w dużej mierze efektem wspomnień i charakteru monitorów CRT: większość gier działała w bardzo niskich rozdzielczościach, z ograniczoną animacją i agresywnymi kompromisami w projektowaniu grafiki.