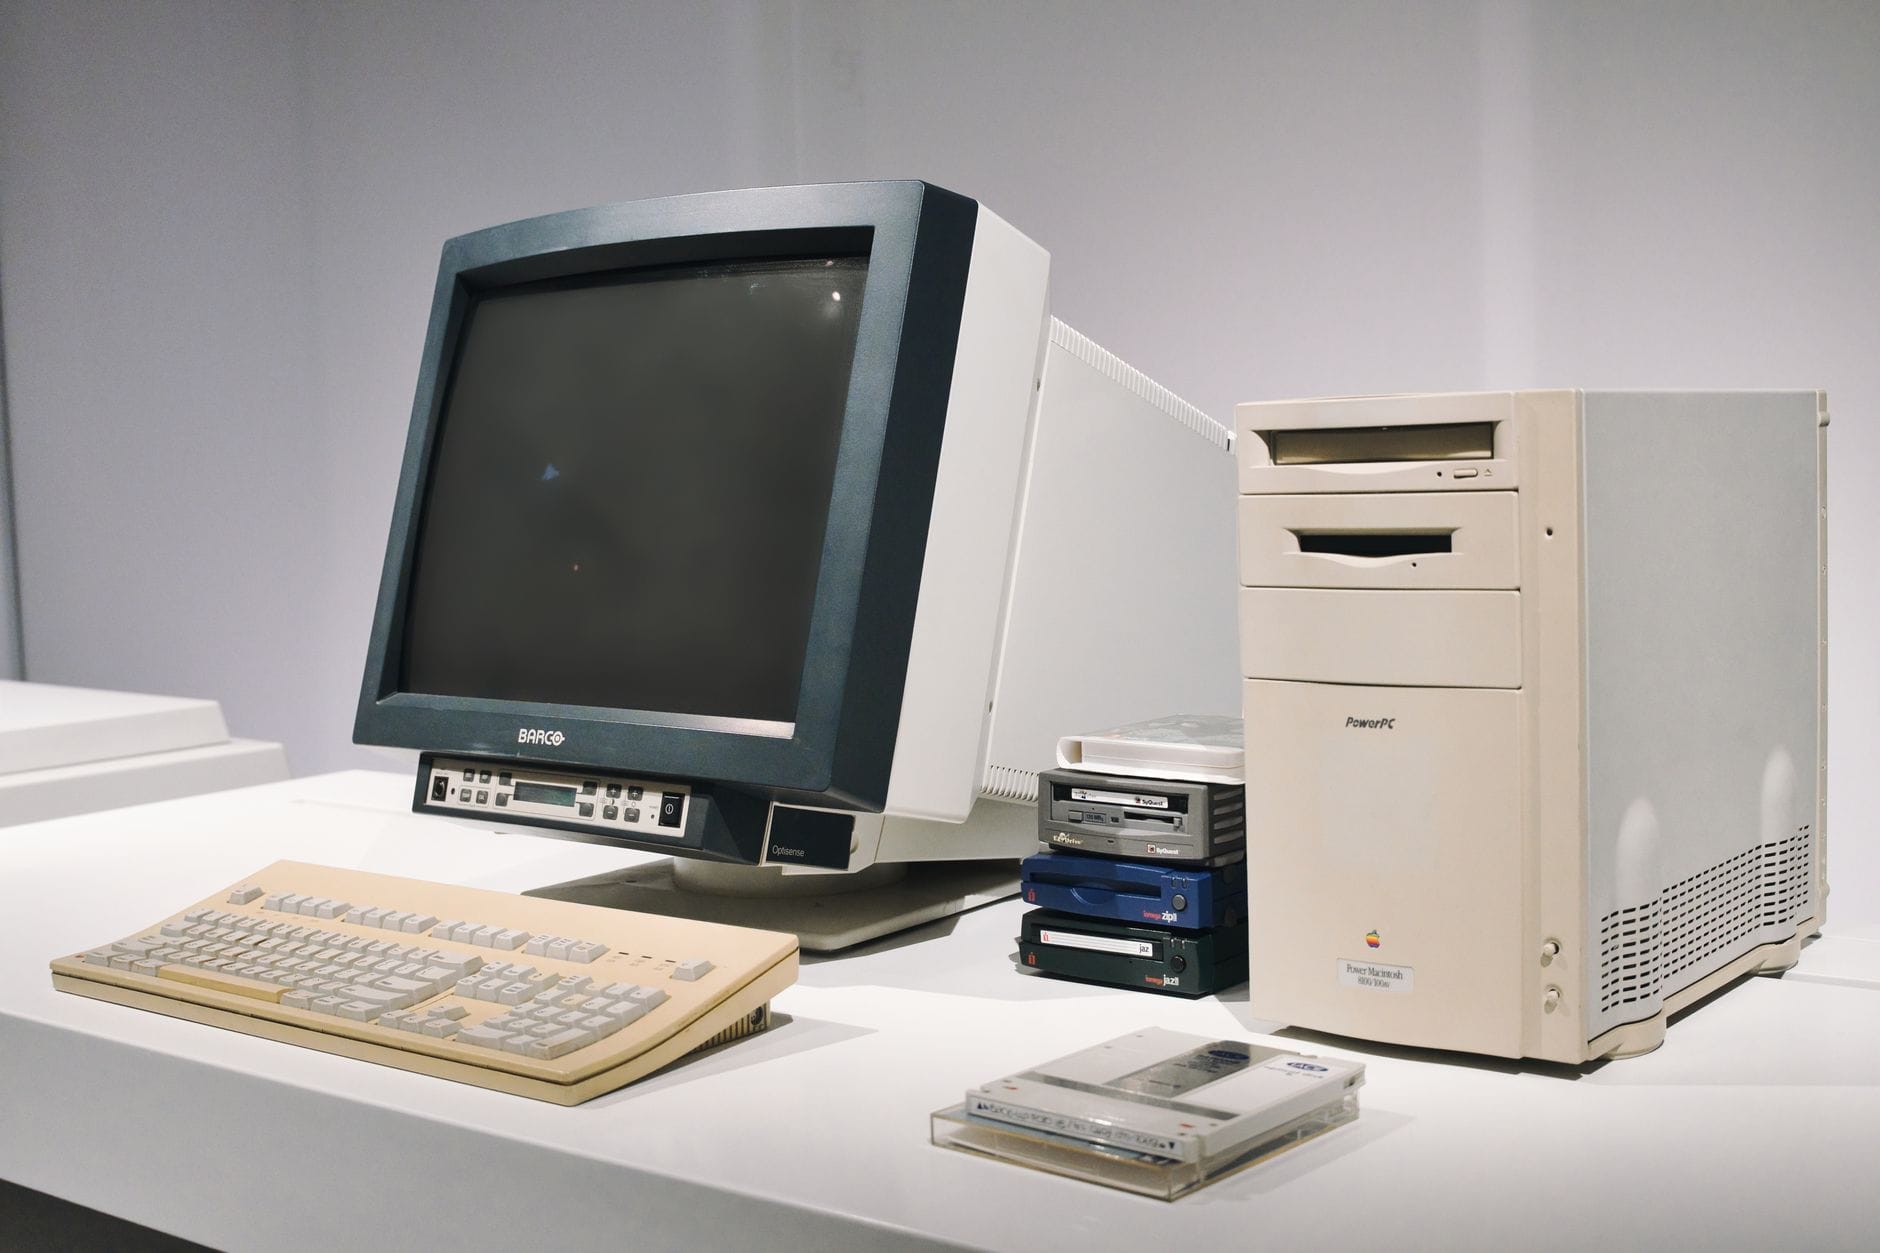
Zapewne niejeden raz zdarzyło Ci się zderzyć z sytuacją, w której nowo zakupiony sprzęt komputerowy nie przyniósł oczekiwanego, drastycznego skoku wydajności. W latach dziewięćdziesiątych czy na początku dwudziestego pierwszego wieku wymiana komputera na nowy, po zaledwie trzech latach użytkowania, oznaczała wejście w zupełnie inną epokę technologiczną. Programy ładowały się błyskawicznie, gry wyglądały nieporównywalnie lepiej, a strony internetowe działały płynnie. Dzisiaj pięcioletni czy nawet siedmioletni procesor w wielu zastosowaniach radzi sobie zupełnie sprawnie, a jego wymiana na najnowszą generację często przynosi jedynie kosmetyczną poprawę w codziennym użytkowaniu. Ta zmiana tempa, która z punktu widzenia konsumenta bywa irytująca, nie jest dziełem przypadku ani złośliwości producentów. To bezpośredni skutek wyczerpywania się jednego z najsłynniejszych trendów w historii technologii, który przez dziesięciolecia kształtował nasze oczekiwania wobec elektroniki.
Mowa oczywiście o prawidłowości, która napędzała rewolucję cyfrową, pozwalała zmniejszać komputery z rozmiarów szaf do urządzeń mieszczących się w kieszeni i drastycznie obniżała koszty mocy obliczeniowej. Zrozumienie, dlaczego ten niesamowity marsz ku miniaturyzacji zwalnia, wymaga spojrzenia za kulisy produkcji układów scalonych. Wymaga też odrzucenia wielu marketingowych mitów, które z biegiem lat narosły wokół pojęć takich jak nanometry, megaherce czy liczba rdzeni. Zamiast szukać prostych odpowiedzi w folderach reklamowych, warto przyjrzeć się fizycznym i ekonomicznym granicom, do których właśnie dotarła branża półprzewodnikowa.
Prawo Moore’a: trafna obserwacja, nie żelazne prawo natury
W powszechnej świadomości utarło się przekonanie, że postęp technologiczny to siła działająca niemal automatycznie, niczym grawitacja czy termodynamika. Przez dekady komputery stawały się szybsze, mniejsze i relatywnie tańsze, co budowało złudzenie, że jest to nieunikniony proces ewolucyjny. W rzeczywistości za tym fenomenem nie stała żadna fundamentalna zasada wszechświata, lecz niezwykle trafna analiza trendów rynkowych, inżynieryjny rygor i gigantyczne nakłady finansowe. Aby zrozumieć naturę tego zjawiska, trzeba cofnąć się do momentu, w którym zostało ono po raz pierwszy sformułowane.
Co Gordon Moore napisał w 1965 roku
W połowie lat sześćdziesiątych ubiegłego wieku układ scalony był wciąż nowinką. Inżynierowie potrafili umieścić na jednym kawałku krzemu zaledwie kilkadziesiąt komponentów. W 1965 roku Gordon Moore, późniejszy współzałożyciel firmy Intel, a wówczas dyrektor do spraw badań i rozwoju
w firmie Fairchild Semiconductor, opublikował w magazynie „Electronics” krótki tekst zatytułowany „Cramming more components onto integrated circuits”. Na podstawie danych z pierwszych lat rozwoju układów scalonych zauważył, że liczba elementów możliwych do umieszczenia na pojedynczym chipie podwajała się mniej więcej co rok. Prognozował, że taki trend utrzyma się przez następną dekadę. Nie przedstawiał prawa fizyki ani gwarancji rozwoju, lecz ekstrapolację opartą na bardzo młodej wtedy branży. [1]
Dziesięć lat później Moore skorygował tempo: zamiast corocznego podwajania liczby tranzystorów mówił o okresie około dwóch lat. W tej formie „prawo Moore’a” zapisało się w historii technologii. Problem w tym, że popularne streszczenie bywa mylące. Nie chodziło o prostą obietnicę, że każdy kolejny komputer będzie dwa razy szybszy ani że użytkownik co dwa lata odczuje podwojenie wydajności. Opisywana była przede wszystkim zdolność przemysłu do upakowywania coraz większej liczby tranzystorów przy podobnym koszcie produkcji układu. [2]
To rozróżnienie ma znaczenie także dziś. Liczba tranzystorów nadal może rosnąć, ale ich wykorzystanie zależy od architektury procesora, pamięci, poboru energii, chłodzenia i rodzaju oprogramowania. Chip z większą liczbą tranzystorów może przeznaczyć część z nich na dodatkowe rdzenie, większą pamięć podręczną, układy graficzne, akceleratory AI albo funkcje bezpieczeństwa. Nie musi więc automatycznie wykonywać pojedynczego zadania dwa razy szybciej. Prawo Moore’a stało się zarazem prognozą, celem inwestycyjnym i wygodnym skrótem myślowym — użytecznym, dopóki nie zastępuje rzeczywistych pomiarów.
Gdy miniaturyzacja napotyka bariery fizyczne i kosztowe, postęp nie znika, lecz przestaje mieć jeden prosty wskaźnik. Coraz częściej decydują o nim spryt projektu układu, wyspecjalizowane akceleratory, łączenie chipów i lepsze wykorzystanie energii, a nie sama liczba nanometrów na opakowaniu.
Dlaczego przez pół wieku prognoza Moore’a działała zaskakująco dobrze
Skoro prawo Moore’a nie opierało się na fundamentach fizyki, w jaki sposób zdołało utrzymać się przy życiu przez ponad pięćdziesiąt lat? Odpowiedź kryje się w ekonomii i psychologii biznesu. W pewnym momencie ta rynkowa obserwacja przeistoczyła się w najpotężniejszą samospełniającą się przepowiednię w historii przemysłu. Cała globalna branża półprzewodników, wyceniana z czasem na setki miliardów dolarów, uznała ten rytm za swój oficjalny harmonogram.
Dla producentów sprzętu, firm tworzących oprogramowanie oraz dostawców zaawansowanych maszyn litograficznych, prawo Moore’a stało się swoistym metronomem. Jeśli firma produkująca procesory chciała utrzymać się na rynku, wiedziała, z jaką gęstością tranzystorów musi wyjść do klientów za dwa lata, ponieważ dokładnie to samo planowała jej konkurencja. Powstały potężne konsorcja i międzynarodowe mapy drogowe (takie jak ITRS – International Technology Roadmap for Semiconductors), które koordynowały wysiłki badawczo-rozwojowe dziesiątek tysięcy inżynierów na całym świecie. Dostawcy materiałów, projektanci obwodów i twórcy oprogramowania układali swoje strategie pod dyktando tego dwuletniego cyklu.
Napędzało to również unikalne zjawisko ekonomiczne. Pomniejszanie tranzystorów sprawiało, że z jednego plastra krzemu (wafla) można było wyciąć więcej układów scalonych, co obniżało koszt wyprodukowania pojedynczego tranzystora. Branża mogła więc zaoferować klientom potężniejsze urządzenia w tej samej cenie, a ogromne zyski ze sprzedaży natychmiast reinwestować w badania nad kolejną, jeszcze mniejszą generacją. Ten cykl sprzężenia zwrotnego działał bez zarzutu do momentu, w którym prawa fizyki zaczęły domagać się swojego.
Od liczby tranzystorów do realnej szybkości: znaczenie skalowania Dennarda
Warto w tym miejscu odpowiedzieć na kluczowe pytanie: dlaczego w ogóle upakowywanie coraz większej liczby elementów na krzemie przekładało się przez lata na to, że komputery fizycznie działały szybciej? Sam fakt posiadania miliardów tranzystorów nie przyspiesza automatycznie obliczeń. Elementem układanki, który łączył prawo Moore’a z realnym doświadczeniem użytkownika, była inna zasada, znana jako skalowanie Dennarda.
Sformułowane w 1974 roku przez Roberta Dennarda prawo głosiło, że w miarę zmniejszania rozmiarów tranzystorów, ich gęstość mocy pozostaje stała. W praktyce oznaczało to coś niesamowitego: mniejsze tranzystory potrzebowały niższego napięcia do działania i mogły przełączać się znacznie szybciej, nie generując przy tym większej ilości ciepła na jednostkę powierzchni. To właśnie skalowanie Dennarda pozwalało inżynierom przez całe lata dziewięćdziesiąte i początek dwudziestego pierwszego wieku systematycznie podnosić taktowanie procesorów – z kilkudziesięciu megaherców do kilku gigaherców.
Użytkownicy doświadczali tego jako czystej, brutalnej siły obliczeniowej. Zegary biły szybciej, więc ten sam program, niezależnie od tego, jak leniwie został napisany, nagle działał błyskawicznie. Niestety, około 2005 roku skalowanie Dennarda uderzyło w mur. Tranzystory stały się tak małe, że zaczęły cierpieć na zjawisko upływu prądu, nawet gdy były w stanie spoczynku. Próba dalszego podnoszenia taktowania doprowadziłaby do stopienia krzemu. Dlatego właśnie częstotliwości taktowania zatrzymały się na poziomie kilku gigaherców i od blisko dwóch dekad rosną niezwykle powoli, a cała uwaga branży musiała przenieść się na wielordzeniowość. [3]
Dlaczego prawo Moore’a przestało wystarczać
Dzisiejsze problemy z prawem Moore’a mają wymiar zarówno fizyczny, jak i ekonomiczny. Zeszliśmy do poziomu, w którym elementy tranzystorów mierzy się w pojedynczych atomach. Na tak niewyobrażalnie małej skali przestają obowiązywać zasady klasycznej fizyki, a do głosu dochodzi mechanika kwantowa. Zjawiska takie jak tunelowanie kwantowe sprawiają, że elektrony potrafią swobodnie przenikać przez bariery wewnątrz tranzystora, co drastycznie utrudnia kontrolowanie przepływu prądu i zmusza inżynierów do projektowania niezwykle skomplikowanych struktur przestrzennych, takich jak FinFET czy Gate-All-Around (GAA). [4]
Jednak jeszcze większym problemem jest ekonomia. Produkcja współczesnych układów scalonych to prawdopodobnie najbardziej skomplikowany proces wytwórczy w historii ludzkości. Nowoczesne maszyny do litografii w ekstremalnym ultrafiolecie (EUV) kosztują setki milionów dolarów za sztukę, a postawienie nowej fabryki pochłania dziesiątki miliardów. Koszty projektowania najnowocześniejszych architektur rosną lawinowo, co sprawia, że na placu boju pozostało tylko kilku graczy na świecie zdolnych do produkcji w najniższych procesach technologicznych.
Oznacza to, że choć wciąż potrafimy upychać więcej tranzystorów na milimetrze kwadratowym, przestało to być opłacalne w starym modelu. Koszt wyprodukowania jednego tranzystora nie spada już tak dynamicznie jak kiedyś. Skoro brutalna miniaturyzacja staje się horrendalnie droga, a fizyka uniemożliwia proste podnoszenie zegarów, inżynierowie musieli znaleźć inne ścieżki rozwoju, aby zaspokoić nienasycony głód na moc obliczeniową.
Jak branża omija ograniczenia: więcej niż mniejszy tranzystor
Zamiast polegać wyłącznie na mniejszych tranzystorach, projektanci układów scalonych weszli w erę innowacji architektonicznych i materiałowych. Najlepszym przykładem tej zmiany jest odejście od budowy ogromnych, monolitycznych rdzeni. Produkcja jednego, wielkiego kawałka krzemu jest ryzykowna – najdrobniejszy błąd fabryczny może sprawić, że cały układ trafi do kosza. Odpowiedzią okazała się technologia chipletów.
Zamiast jednego gigantycznego układu, producenci łączą na jednym podłożu kilka mniejszych, wysoce wyspecjalizowanych modułów (chipletów). Pozwala to na przykład wyprodukować rdzenie obliczeniowe w najdroższej, najnowszej technologii, ale moduły odpowiedzialne za komunikację czy operacje wejścia/wyjścia wykonać w starszym, tańszym procesie. To mistrzowska optymalizacja kosztów i uzysku z wafli krzemowych.
Kolejnym przełomem jest pakowanie trójwymiarowe (3D packaging). Kiedy brakuje miejsca w poziomie, inżynierowie zaczęli budować wzwyż, podobnie jak architekci stawiający wieżowce w zatłoczonych centrach miast. Stosuje się to już z powodzeniem, umieszczając dodatkowe pokłady szybkiej pamięci bezpośrednio na procesorze. Znacząco skraca to dystans, jaki muszą pokonać dane, a w świecie, w którym elektrony przemieszczają się z prędkością zbliżoną do światła, krótsza ścieżka oznacza mniejsze opóźnienia i ogromne oszczędności energii.
Wreszcie,
branża zwróciła się ku daleko idącej specjalizacji układów, odchodząc od polegania wyłącznie na uniwersalnych procesorach głównego przeznaczenia. Koncepcja architektur dziedzinowych (Domain-Specific Architectures) opiera się na tworzeniu krzemu zoptymalizowanego pod kątem konkretnych, wąskich zadań. Zamiast obciążać tradycyjny układ skomplikowanymi obliczeniami kryptograficznymi, dekodowaniem wideo czy wnioskowaniem w gigantycznych modelach analitycznych, zadania te deleguje się do wyspecjalizowanych jednostek. Dzięki precyzyjnemu dostosowaniu struktury logicznej do charakterystyki konkretnego problemu matematycznego, takie akceleratory osiągają drastycznie wyższą wydajność przy ułamku zużycia energii, ignorując w ten sposób ograniczenia wynikające z zahamowania miniaturyzacji.
Kolejnym kluczowym aspektem tej nowej ery jest głęboka integracja sprzętu z oprogramowaniem, znana jako hardware-software co-design. W czasach bezproblemowego działania prawa Moore’a twórcy oprogramowania mogli nierzadko pozwalać sobie na luksus pisania mało zoptymalizowanego kodu. Panowało przekonanie, że za kilkanaście miesięcy nowa generacja sprzętu brutalną siłą taktowania zrekompensuje wszelkie braki programistyczne. Dziś ten darmowy obiad się skończył. Nowoczesne kompilatory, systemy operacyjne i algorytmy muszą być projektowane z pełną świadomością architektury fizycznej – odpowiednio zarządzać pamięcią podręczną i zrównoleglać wątki, aby wycisnąć każdy ułamek mocy z układów wielordzeniowych i chipletowych.
Zmierzch tradycyjnego, liniowego rozumienia prawa Moore’a nie zwiastuje zatem technologicznego zastoju. Oznacza jedynie, że miara postępu przestała być jednowymiarowa i banalnie prosta do uchwycenia na wykresie. Zamiast polegać na prostej ekstrapolacji rozmiaru i liczby elementów w krzemie, branża półprzewodników weszła w fazę inżynieryjnej finezji. Kombinacja przestrzennego pakowania, sprytnych podziałów architektonicznych, nowatorskich materiałów oraz absolutnej specjalizacji pozwala na ciągły wzrost wydajności całych platform obliczeniowych. Gordon Moore dał przemysłowi genialny kompas na pierwsze pół wieku jego istnienia, jednak dzisiejsi projektanci – zderzając się z barierami ekonomii i mechaniki kwantowej – z powodzeniem nawigują już według zupełnie nowych map.
Wydajność nie jest już jednym wskaźnikiem
To przesunięcie ma praktyczne konsekwencje dla sposobu oceniania nowych procesorów. Przez lata łatwo było spojrzeć na taktowanie albo liczbę tranzystorów i założyć, że nowszy układ będzie po prostu szybszy. Dziś taki skrót myślowy często prowadzi na manowce. Układ z większą liczbą tranzystorów może zużywać dodatkowy budżet krzemowy na pamięć podręczną, mechanizmy bezpieczeństwa, układy graficzne, silniki multimedialne lub akceleratory sztucznej inteligencji. Każdy z tych elementów może poprawiać użyteczność całego urządzenia, ale nie musi przyspieszać pojedynczego, tradycyjnego programu.
Równie mylące bywa porównywanie samych nazw procesów technologicznych, takich jak „5 nm” czy „3 nm”. Nie są one już dosłowną miarą długości konkretnego elementu tranzystora i nie dają prostego, uniwersalnego sposobu porównania fabryk różnych producentów. To przede wszystkim nazwy generacji technologicznych. O rzeczywistym postępie decydują między innymi gęstość upakowania, właściwości tranzystorów, zużycie energii, jakość procesu produkcyjnego i architektura gotowego układu. Dwa chipy wykonane w podobnie nazwanym procesie mogą więc oferować zupełnie inny kompromis między osiągami, poborem mocy i kosztem.
Coraz częściej głównym ograniczeniem nie jest też samo wykonanie obliczenia, lecz dostarczenie danych we właściwe miejsce i we właściwym czasie. Przenoszenie informacji między pamięcią a procesorem wymaga energii i generuje opóźnienia. Z tego powodu współczesne konstrukcje rozbudowują pamięci podręczne, stosują pamięć o dużej przepustowości blisko układu obliczeniowego oraz dzielą zadania tak, aby dane nie musiały niepotrzebnie krążyć po całym systemie. W wielu zastosowaniach lepiej zaprojektowany przepływ danych daje większą korzyść niż niewielki wzrost częstotliwości zegara.
Energia stała się równie ważna jak szybkość
Koniec darmowego wzrostu taktowania zmienił również priorytety projektowania. W serwerowni dodatkowy pobór energii oznacza nie tylko wyższy rachunek za prąd, ale też większe wymagania dotyczące chłodzenia i zasilania. W laptopie przekłada się na temperaturę obudowy, hałas wentylatorów oraz czas pracy na baterii. W smartfonie margines energetyczny jest jeszcze mniejszy. Dlatego wydajność coraz częściej ocenia się nie jako maksymalną liczbę operacji, lecz jako liczbę użytecznych operacji wykonanych przy określonym limicie mocy.
To jeden z powodów, dla których układy heterogeniczne stały się tak powszechne. Obok dużych rdzeni przeznaczonych do wymagających zadań pojawiają się mniejsze rdzenie energooszczędne, procesory sygnałowe, jednostki graficzne i wyspecjalizowane akceleratory. System operacyjny musi następnie zdecydować, gdzie uruchomić dane zadanie. Proste odtwarzanie muzyki nie potrzebuje tego samego rodzaju zasobów co kompilacja programu, renderowanie grafiki czy analiza obrazu z kamery. Dobrze wykonany podział pracy ogranicza pobór energii bez zauważalnego pogorszenia komfortu użytkownika.
Nie należy jednak traktować specjalizacji jako rozwiązania uniwersalnego. Akcelerator jest bardzo skuteczny wtedy, gdy zadanie da się jasno opisać, często powtarza się i pasuje do jego architektury. Uniwersalny procesor pozostaje niezastąpiony tam, gdzie liczy się elastyczność, zmienny charakter programu albo szybkie reagowanie na nieprzewidziane warunki. Z tego względu przyszłość nie polega raczej na całkowitym zastąpieniu CPU przez jeden typ wyspecjalizowanego krzemu, lecz na łączeniu różnych jednostek w spójne systemy.
Prawo Moore’a jako punkt odniesienia, nie obietnica
Prawo Moore’a nadal ma znaczenie jako historyczny opis niezwykłego okresu rozwoju elektroniki i jako przypomnienie, jak skuteczne potrafi być konsekwentne skalowanie produkcji. Nie powinno być jednak odczytywane jako gwarancja, że każde kolejne dwa lata przyniosą identyczny skok wydajności przy niższej cenie. Współczesny postęp jest bardziej nierówny. Jedna generacja może przynieść przede wszystkim lepszą efektywność energetyczną, inna zwiększyć możliwości obliczeń AI, a jeszcze inna poprawić komunikację między chipletami lub dostęp do pamięci.
To, czy użytkownik odczuje zmianę, zależy od konkretnego zastosowania. Osoba pracująca głównie z dokumentami niekoniecznie zauważy korzyść z większej liczby rdzeni, podczas gdy montaż wideo, symulacje naukowe czy obsługa dużych modeli językowych mogą wykorzystać ją bardzo skutecznie. Tak samo rosnąca liczba tranzystorów nie usuwa automatycznie wąskich gardeł w źle zaprojektowanym programie, wolnej pamięci masowej albo sieci.
Najważniejsza zmiana polega więc na odejściu od prostego pytania: „ile tranzystorów więcej?”. Znacznie trafniejsze jest pytanie, jak cały system wykorzystuje energię, pamięć, komunikację i wyspecjalizowane zasoby do rozwiązania realnego problemu. Miniaturyzacja nadal pozostaje ważna, lecz nie jest już samotnym motorem postępu. Prawo Moore’a przestało wystarczać nie dlatego, że innowacja się skończyła, ale dlatego, że dalszy rozwój wymaga dziś znacznie więcej niż zmniejszenia kolejnego elementu na płytce krzemu.
Najważniejsze wnioski
- Prawo Moore’a było obserwacją trendu dotyczącego wzrostu liczby tranzystorów w układach scalonych, a nie prawem fizyki ani gwarancją podwajania wydajności komputerów.
- Przez wiele lat postęp odczuwalny przez użytkowników wspierało skalowanie Dennarda, które umożliwiało zwiększanie częstotliwości taktowania bez proporcjonalnego wzrostu poboru energii i ciepła.
- Około 2005 roku skalowanie Dennarda napotkało bariery związane z upływem prądu i temperaturą, dlatego dalszy wzrost wydajności zaczął opierać się między innymi na wielordzeniowości.
- Dalsza miniaturyzacja tranzystorów jest coraz trudniejsza z powodu zjawisk kwantowych, ograniczeń konstrukcyjnych i rosnących kosztów projektowania oraz produkcji układów.
- Większa liczba tranzystorów nie oznacza automatycznie dwukrotnie szybszego działania. Znaczenie mają także architektura, pamięć, chłodzenie, pobór energii i oprogramowanie.
- Współczesny postęp wynika coraz częściej z wyspecjalizowanych akceleratorów, łączenia chipów, lepszego wykorzystania energii i optymalizacji projektu, a nie wyłącznie z liczby nanometrów.
Pytania od czytelników
Czy większa liczba tranzystorów zawsze oznacza szybszy procesor?
Dlaczego częstotliwość procesorów nie rośnie już tak szybko jak dawniej?
Czy prawo Moore’a całkowicie przestało obowiązywać?
Co dziś może zastępować prostą miniaturyzację tranzystorów?
Źródła
- [1] Computer History Museum – 1965: "Moore's Law" Predicts the Future of Integrated Circuits ↑
- [2] Intel – Moore's Law ↑
- [3] IEEE Spectrum – The Multiple Lives of Moore’s Law ↑
- [4] Nature – From Moore to more: the future of silicon chips ↑